


Voick Voice Simulator は、声帯の振動と、喉・口・鼻を伝わる音の響きをコンピューター上で計算する研究用の発声シミュレーターです。「母音を変えると、なぜ高音の出しやすさが変わるのか」「鼻への通り道を開くと、声はどう変化するのか」といった疑問に対して、条件を一つずつ変えながら物理的な仕組みを調べるために開発しています。
この記事で扱う v1.0 は、2026年10月24日時点で公開している「鼻腔共鳴」と「母音と高音」の2本の記事で使ったモデル構成と計算条件をまとめたバージョンです。どのような数理モデルを組み合わせているのか、先行研究のデータとどこまで一致しているのか、そして計算結果から何が言えて何が言えないのかを整理しました。
v1.0 で行っているのは、音響理論の厳密解や先行論文の計算値とプログラムの出力が一致するかの確認までです。人の歌声や声帯の動きを実際に計測したデータとの比較や、このモデルをもとに考えた練習メニューの効果検証は、今後の課題として残っています。
声を計算する全体の仕組み
声を出すとき、肺から送られた息の圧力で声帯が振動し、声門を通る空気の流れが周期的に変化します。その空気の粗密が喉や口の中(声道)の空気を揺らし、口や鼻から音として外へ出ていきます。このとき声道の中で生まれた音圧は声帯側にも跳ね返ってくるため、シミュレーターでは「声帯の振動」と「声道の共鳴」を切り離さず、互いに影響し合うひとつの仕組みとして計算しています。
| 対象 | v1.0 で使っているモデル |
|---|---|
| 声帯 | 表面側の上下2つの質量(カバー)と、奥側の1つの質量(ボディ)をばねとダンパー(減衰)でつないだ三質量の body-cover モデルです。気流から受ける圧力や組織の弾性、左右の声帯がぶつかる接触力を計算します。 |
| 咽頭・口腔 | 声門から唇までの通り道を短い円管の連なりとして表し、区間ごとの長さと断面積から共鳴特性を求めます。粘膜壁の振動、空気の粘性や熱伝導、唇からの音響放射によるエネルギー損失も含めています。 |
| 鼻腔 | 咽頭の途中で口側と鼻側の2ルートに分岐するモデルです。「鼻腔共鳴」の記事では、上咽頭の先で左右の鼻道に分け、それぞれに上顎洞・前頭洞・蝶形洞を表す共鳴器をつないだ構成を使っています。 |
| 声門下と相互作用 | 声帯より下の気管側も簡略化した管としてつないでいます。声道と声門下の周波数特性を時間領域の反射応答に変換し、刻々と声帯へ跳ね返る音圧を計算します。 |
声帯:三質量・四質量・連続体モデルの違い
声帯の振動を計算するときは、組織を少数のブロック(質量)に置き換えて解くやり方と、やわらかくつながった組織を細かい網目に区切って解くやり方(連続体モデル)があります。Voick Voice Simulator には三質量・四質量・連続体の3種類を実装していますが、v1.0 の2記事でメインのグラフや比較音声に使っているのは三質量モデルです。四質量モデルは声区の切り替わりなどを調べるための拡張実装で、連続体モデルは「母音と高音」の記事で補助的な確認に使いました。
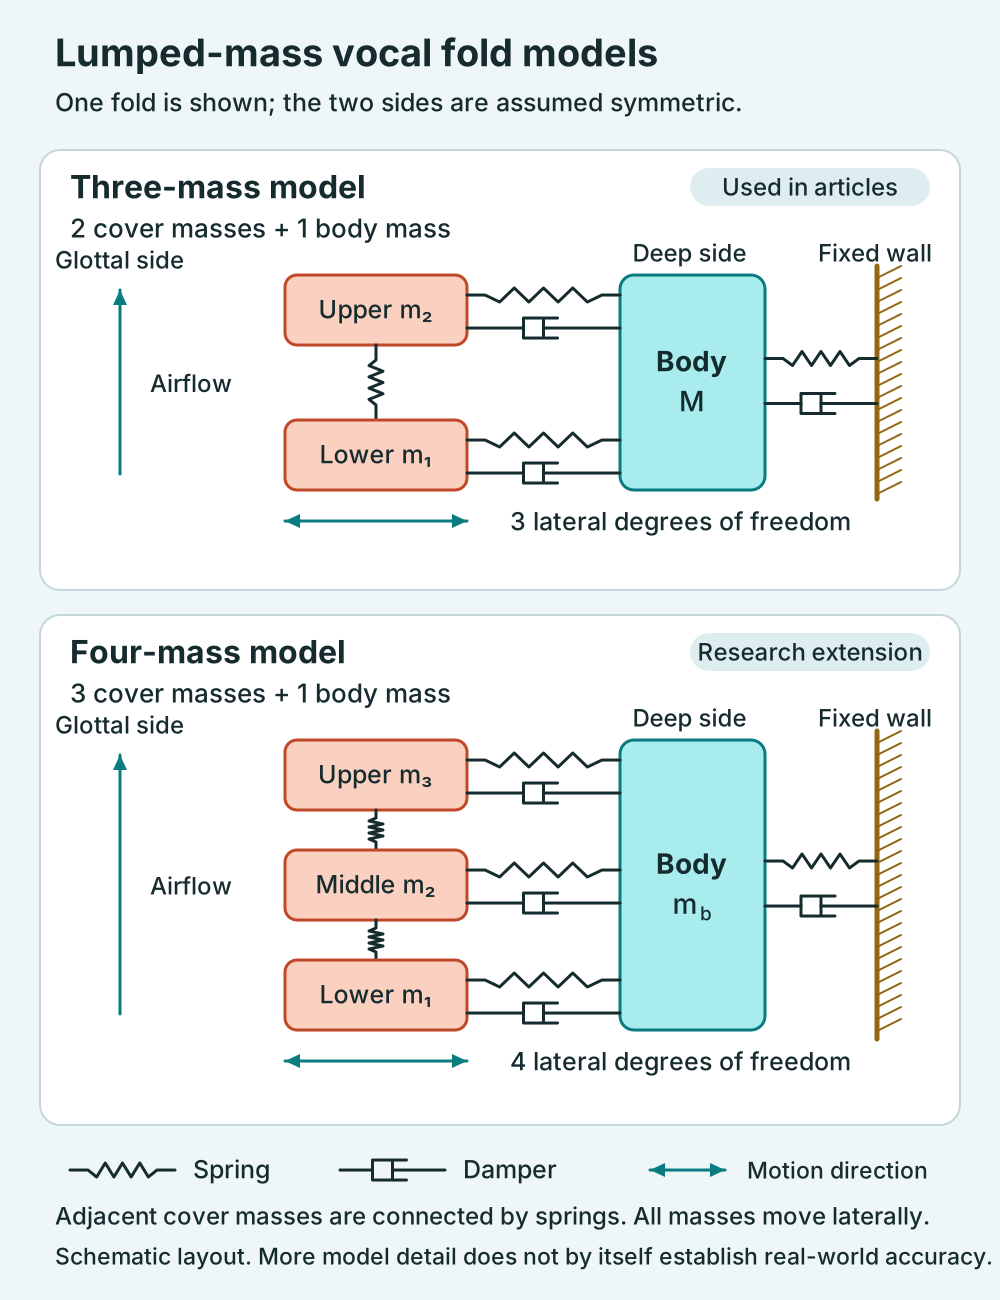
三質量モデルは Story & Titze(1995)の body-cover モデルをベースに、筋肉の活動度から質量やばね定数を算出する Titze & Story(2002)の変換則を組み合わせています。実装にあたっては、同著者らによる音声合成器 LeTalker の式・定数や後続論文の記述も参照し、算出される質量・ばねの値が Lowell & Story(2006)の表と一致することを確認しました。なお、左右の声帯が接触したときの処理や減衰の与え方には Voick 側の仮定も入っているため、元論文の挙動をすべてそのまま再現しているわけではありません。
四質量モデルは Tokuda & Herzel(2009)を参考に、表面のカバーを下・中・上の3つに分けた構成です。各質量の位置と上下端を折れ線で結んで声帯表面の形を表すため、三質量モデルよりも上下方向の動きの差(下から上へうねるように伝わる粘膜の動き)を表現しやすくなります。もっとも、あくまで4つのブロックによる近似であり、組織全体の連続的な変形まで解くものではありません(今回の2記事の計算にはこの四質量モデルは使っていません)。
連続体モデルでの声帯の扱い方
連続体モデルでは、声帯を「粘膜・靱帯・筋肉(甲状披裂筋)」の3層構造を持つやわらかい組織として扱います。正面から見た声帯の断面(前額断)を細かい三角形の網目(メッシュ)に区切り、隣り合う要素どうしの力のつり合いから、組織全体がどう変形して振動するかを解いていきます(有限要素法)。
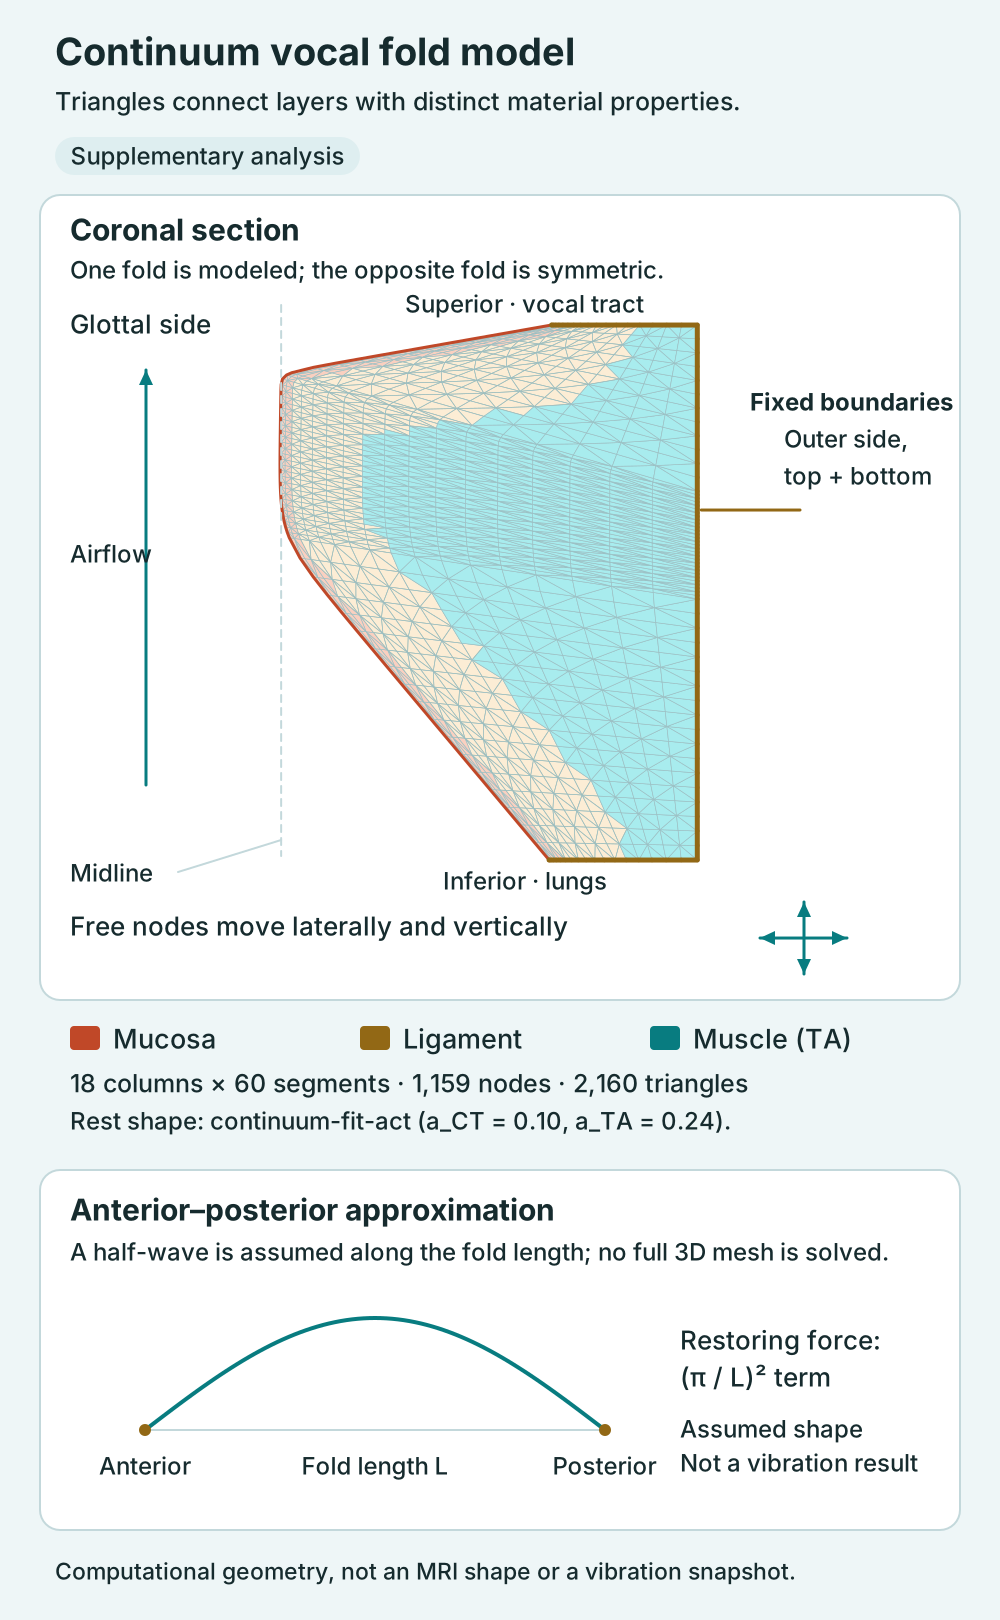
上の図は、補助計算で使っている設定(continuum-fit-act、筋活動パラメータ a_CT = 0.10・a_TA = 0.24・a_LC = 0.50)から生成した振動前の初期メッシュです。断面を18列×60区間(1,159節点・2,160三角形要素)に分割しており、左右の声帯が対称に動く前提で片側だけを計算します。外側と上下端の境界は固定し、内側の自由な節点が横方向と上下方向の2方向に動く仕組みです(図は計算用の初期形状を描いたもので、特定の人の声帯を計測して起こした実測形状や、振動中の一瞬を示したものではありません)。
なお、この連続体モデルは奥行き方向まで自由に変形するフル3次元計算ではなく、「2.5次元」の近似をとっています。左右・上下の断面内についてはメッシュの変形を直接解きますが、前後の奥行き方向については、前端と後端でゼロになり中央で最大になる半波のカーブ(正弦波)をあらかじめ仮定して復元力に反映させています。
連続体モデルは、層ごとの変形や表面を伝わる波の動きを、三質量・四質量モデルより細かく表現できるのが強みです。ただし、初期形状や組織の硬さ・減衰、気流の扱い、境界条件が現実とずれていれば、メッシュをどれだけ細かく切っても実際の声に近づくとは限りません。現時点では「連続体モデルのほうが人の発声を正確に予測できる」といった精度の比較検証までは行っていません。
声道:通り道の形を「短い管の列」に置き換える
喉から唇までの声道(咽頭・口腔)の形状には、Story(2008)が成人男性1名の MRI 画像から求めた11母音の断面積データを基準として使っています。「母音と高音」の記事で扱った「イ」「ア」や、「鼻腔共鳴」の記事の「ア」は、このデータをそのまま用いたものです。
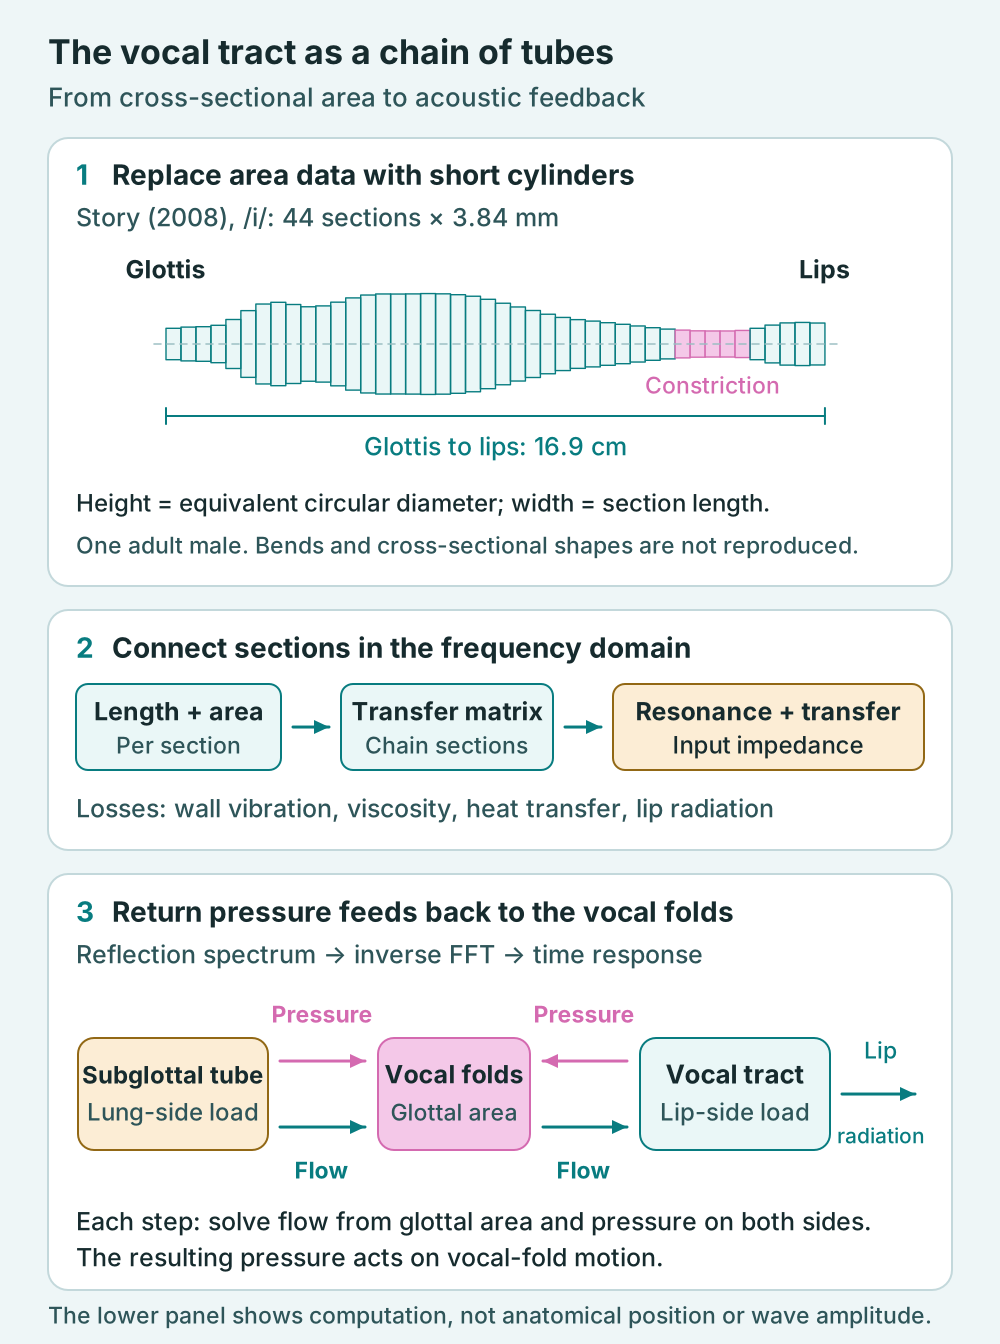
音響計算で使うのは、輪切りにした各区間の「長さ」と「断面積」の2つだけです。上の図では、各区間の断面積を同じ面積の円に換算してパイプの太さとして描いています。実際の声道のように喉から口へ曲がっている形状や、丸くない断面の輪郭までそのまま解いているわけではありませんが、太さの変わる管を順につないで音の反射や損失を計算することで、口から出る音の特性と声帯へ跳ね返る音圧を求めることができます。
一方、日本語の「ウ」は英語の /u/ ほど唇を丸めないため、英語話者である Story(2008)の /u/ をそのまま使わず、日本語話者の実測値に合わせて声道の形を作っています。具体的には、Yazawa & Kondo(2019)による日本人男性の短母音「ウ」の平均値(F1 = 348 Hz・F2 = 1435 Hz)に共鳴周波数が一致するよう、Story のデータから抽出した2つの形状変化モードを組み合わせました。音響特性を日本語の「ウ」にそろえた合成形状であり、日本語話者の発声を MRI で直接測った形そのものではありません。
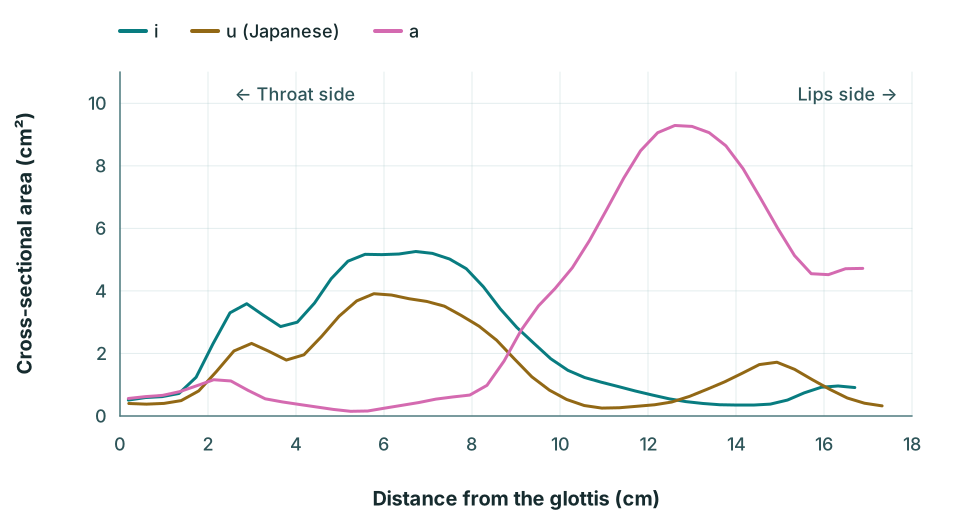
なお、各記事に掲載している頭部の解剖イラストや3Dの断面図は、舌や軟口蓋の位置関係を視覚的にわかりやすく伝えるためのもので、数値計算に使っている断面積データとは役割を分けています。また、成人男性1名の形状をベースにしているため、年齢や体格、声道の長さ、歌唱経験などが異なるすべての人に同じ数値が当てはまるわけではありません。
鼻腔:左右をまとめるモデルと分けるモデル
既定の鼻腔モデル(図上段の merged)では、左右の鼻道を合わせた全長 12.6 cm・12区間の1本の管として表し、接続する声道の長さに応じて全体の寸法を調整しています。鼻腔内の入り組んだひだ(鼻甲介)によって壁の表面積が広くなる効果を「円管の4.0倍の周長」として近似し、途中に左右合計 30 cm³ の上顎洞を表す共鳴器をつないでいます。これらは先行研究の知見を組み合わせて作った代表的な条件であり、声道データと同じ1名の鼻腔全体を計測して再現した形ではありません。
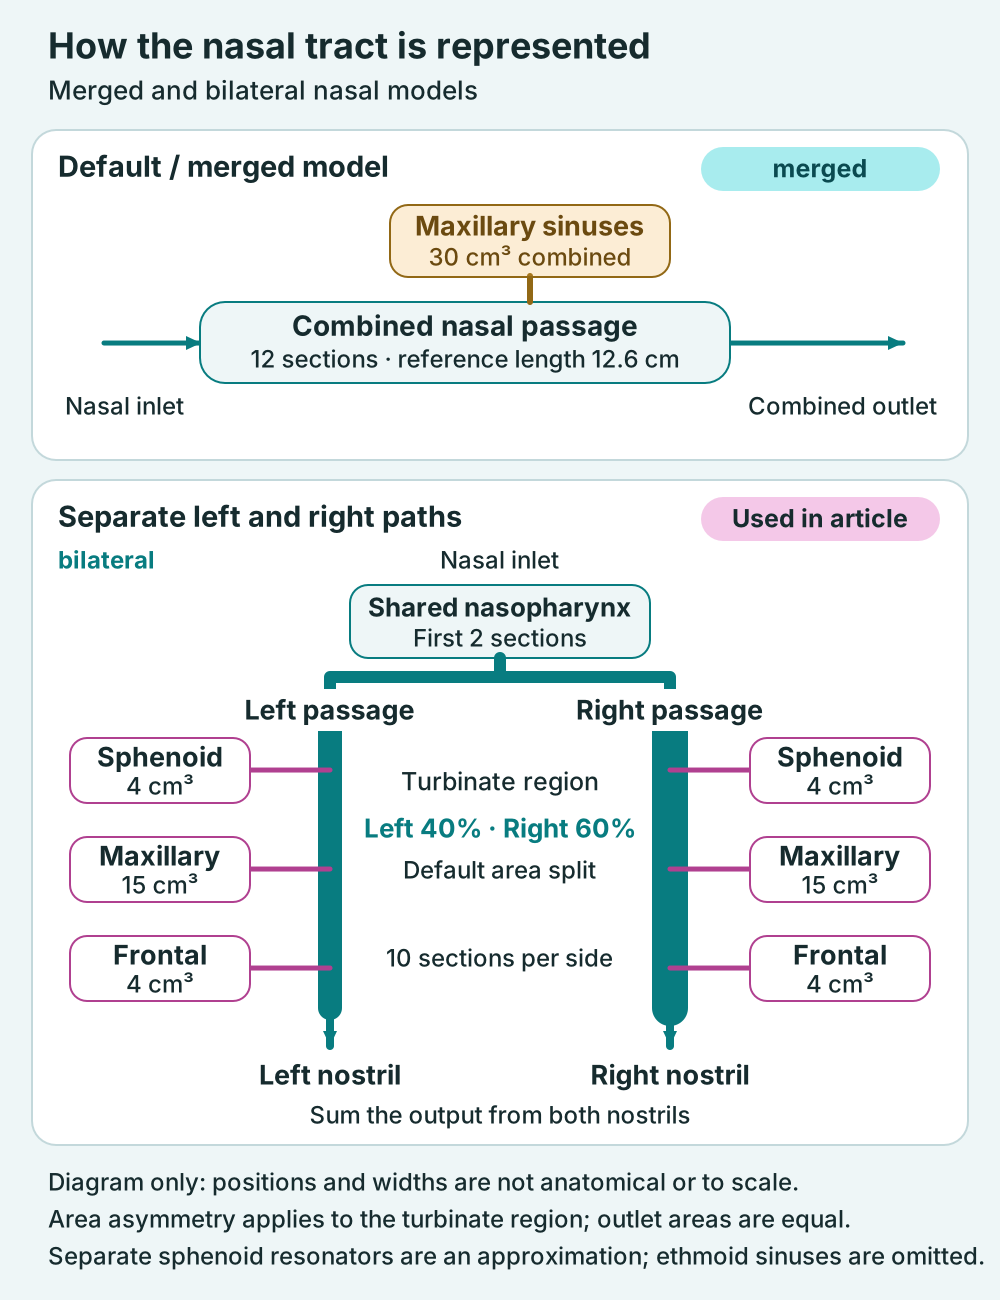
「鼻腔共鳴」の記事では、左右の鼻道を別々に計算する bilateral モデル(図下段)を使っています。入口にあたる最初の2区間を共通の上咽頭とし、その先を左右10区間ずつの鼻道に分けて、左右の外鼻孔から別々に音が出る構造です。それぞれの鼻道には蝶形洞・上顎洞・前頭洞を表す共鳴器を細い通路でつないでおり、声道の長さに合わせて鼻道の寸法や副鼻腔の体積も連動して変わります(図中の数値は基準寸法での既定値で、箱や線の配置・大きさは計算上のつながりを示した模式図です)。これにより、左右の鼻の通り具合の違いや、複数の副鼻腔が音響特性に与える影響を調べることができます。
もっとも、この bilateral モデルも左右の鼻腔を個別に MRI から起こしたものではなく、合計の断面積を左右に振り分ける近似をとっています。初期設定では、入口直後と外鼻孔は左右等分とし、鼻甲介がある区間を右 60%・左 40% に配分しています。また、蝶形洞は左右別の共鳴器として近似しており、蝶形洞を介した左右間の結合や篩骨洞は含めていません。なお、v1.0 の「鼻腔共鳴」の記事で鼻腔をつないだ計算(グラフと比較音声の音声2・4)は、すべて下段の bilateral モデルをこの初期設定のまま使っています。
また、軟口蓋が上がって鼻への空気の通り道が閉じているときに、口の天井(口蓋)の振動を通じて鼻腔側へ音が伝わる現象については、Dang & Honda(1996)の考え方を参考にした「経軟口蓋結合」の簡略モデルを使っています。採用した組織の物性値と元論文の等価インピーダンス式との厳密な換算・対応については追加の照合が必要な段階であり、歌っているときに鼻や顔まわりが震える体感そのものを計算するモデルではありません。
モデルの検証で確認していること
シミュレーターの検証では、「プログラムが数式どおりに正しく動いているか」という確認と、「実際の人の発声をどこまで再現できているか」という確認を切り分けて考える必要があります。そのため、「理論解や先行論文の計算値と一致するか」「実測値に近づくようパラメータを調整したか」「調整に使っていない未知の実測データでも予測が当たるか」の3つを混同しないように整理しています。
| 照合の対象 | 確認結果 | この照合で確かめていること |
|---|---|---|
| 損失のない一様な管の理論解 | 長さ 17.5 cm の一様管の理論共鳴周波数(500・1500・2500・3500 Hz)に対し、誤差 0.2% 以内の基準を満たしました。 | 基本となる声道の音響計算が、物理理論どおりに動いていること。 |
| Story(2008)の11母音の計算値 | 11母音すべての第1〜第3フォルマント(F1〜F3)について、論文中の計算値との差が 3% 以内の基準を満たしました。 | 同じ断面積データを入力したときに、先行研究のモデルと整合する共鳴周波数が得られること。 |
| Lowell & Story(2006)Table I | 4通りの筋活動条件すべてで、質量・ばね定数の7項目が論文の表に対し誤差 0.2% 以内の基準を満たしました。 | 筋肉の活動度から声帯モデルの物性値を求める変換式が、文献の表と整合していること。 |
| 周波数領域と時間領域の音響応答 | テストした「イ・ア・ウ」の声道および声門下で、第1〜第3ピークの位置の差が 0.5% 未満、帯域幅の差が 10% 未満でした。 | 声帯モデルとつなぐために時間領域へ変換した反射応答が、元の音響特性を保っていること。 |
表の数値は、v1.0(2026年10月24日時点)の自動テストで設けている合格基準です。ここで気をつけたいのは、これらはあくまで「計算プログラムとしての整合性」を確かめた結果であり、「生身の人の声を数パーセントの誤差で予測できる」という意味ではない点です。たとえば Story(2008)との照合で比べている相手は、論文に掲載された「モデル上の計算値」であって、実際の録音から測ったフォルマントではありません。実は原論文でも、MRI 断面から計算した値と本人の録音から求めた値との間には最大で約 36% の開きが報告されており、先行研究の計算と一致することだけでは人の声に対する予測精度は判断できません。
実測に合わせた調整値と、まだ検証が足りない部分
モデルの中には、文献の実測値に近づくようあらかじめ調整したパラメータも含まれています。たとえば声門下(気管側)のモデルでは、文献にある声門下共鳴の周波数帯に近づくよう、管壁の共鳴周波数を 400 Hz に設定しています。計算結果がその範囲に収まるのは調整が意図どおり機能していることの確認であり、独立したデータに対する予測精度を証明するものではありません。
鼻腔内の損失や副鼻腔による反共鳴についても、周波数ごとの音の変化は計算できるものの、実際の鼻腔で生じる「谷の深さ」や「帯域幅」と数値レベルでどこまで合っているかは十分に照合できていません。個人差を想定して鼻腔の形状や損失の大きさを変えたときに、記事で示した傾向がどこまで変わらずに成り立つかも、引き続き確かめていく必要があります。また、bilateral モデルの鼻腔の部分だけで比べると、左右の鼻道の太さの違いで加わる反共鳴は約 1.3 kHz に出ており、先行研究で報告されている 1.6〜2.5 kHz(Dang, Honda & Suzuki 1994、Pruthi ら 2007)より低めです。左右の断面積を合計から振り分けているだけで、左右それぞれの実測値を使っていないことが原因と考えています。
公開中の2記事で使った計算条件
同じシミュレーターでも、声道の形や声帯の設定、肺からかける圧力、書き出し時の音量処理によって結果は変わります。再現性のため、v1.0 を使った2本の記事での主な計算条件を以下にまとめます。なお、文中に出てくる a_CT(輪状甲状筋)・a_TA(甲状披裂筋)・a_LC(声門を開閉する筋群の働き)は、モデル上で筋活動の強さを無次元の数値として与える操作パラメータであり、歌い手が自分の筋肉の力加減をその数値に合わせるための指標ではありません。
「鼻腔共鳴」の記事
三質量の声帯モデルに、Story(2008)の母音「ア」(声道長 17.1 cm)と声門下モデルをつないで計算しました。4つの比較音声に共通する設定は、a_CT = 0.53・a_TA = 0.24・a_LC = 0.5、肺側から与える圧力 0.8 kPa、計算時間 2.8 秒です。
| 比較音声 | 変更した条件 | 計算された声の高さ(F0) |
|---|---|---|
| 音声1:通常の「ア」 | 鼻への通り道を閉鎖。喉頭蓋管の追加の狭めなし。 | 約 176.7 Hz |
| 音声2:鼻へ息を通した「ア」 | 鼻への開口面積を 1.2 cm² に変更。 | 約 178.0 Hz |
| 音声3:喉頭蓋管を狭めた「ア」 | 鼻への通り道は閉鎖し、声門上 2.5 cm の区間を断面積 0.3 cm² に変更。 | 約 180.2 Hz |
| 音声4:音声3から鼻へ息を通した「ア」 | 喉頭蓋管の狭めを保ったまま、鼻への開口面積を 1.2 cm² に変更。 | 約 179.0 Hz |
4つの条件でそろえているのは、あくまで「筋活動パラメータ」と「肺の圧力」の設定値です。声道側の条件を変えると声帯へ跳ね返る音圧も変わるため、実際の声帯の揺れ方や、結果として出る声の高さ(F0)は表のとおりわずかに変化します。また、鼻への通り道を開く条件(音声2・4)では、軟口蓋が下がった分だけ口腔の奥の通路が狭くなる効果も簡略化して含めています。
鼻腔には左右の鼻道を分ける bilateral モデル(鼻甲介の区間を右 60%・左 40%、上顎洞・前頭洞・蝶形洞を左右に1つずつ)を使っており、左右を1本にまとめた merged モデルはこの記事の図・音声には使用していません。また、記事内で「鼻への開口面積を変えたとき」の図と、「閉じた口蓋を介して鼻腔へ音が伝わるとき」の図は、それぞれ別の計算条件で出力しています。
音声波形は、口と鼻の出口から出る空気の流量(体積速度)を合計し、その時間微分を放射音の近似として生成しました。モデル内の相対的な音量差がそのまま聞き比べられるよう、4つの音声すべてに共通の倍率をかけて書き出しています。この設定で鼻への通り道を開くと、通常の「ア」では約 8.6 dB、喉頭蓋管を狭めた「ア」では約 5.4 dB、実効値が下がりました。ただし、これは室内で測った絶対的な音圧レベルや、すべての歌い手に共通する減衰量を表す数値ではありません。
「母音と高音」の記事
三質量の声帯モデルに、「イ」「ア」および日本語の「ウ」を表す声道モデルと声門下モデルをつないで計算しました。声道単体での F1 は、「イ」が約 329 Hz、「ウ」が約 348 Hz、「ア」が約 697 Hz です。
「発声に必要な最小の肺圧(発声閾値圧)」のグラフでは、a_TA = 0.24・a_LC = 0.5 に固定したまま a_CT を段階的に変え、声帯の振動が持続する圧力を探しています。1条件につき 0.4 秒間計算し、立ち上がりを過ぎた 0.25 秒以降の波形を見て、50〜2500 Pa の範囲を 10 Pa 刻みの精度まで絞り込みました。この設定では、「イ」と「ウ」の F1 付近で必要な圧力が大きく跳ね上がっています。なお、これはモデル内で「振動が続くかどうか」を判定した値であり、人が歌うときに感じる苦しさを直接測ったものではありません。
| 聞き比べの音声 | 肺圧と a_CT | 計算された声の高さ(F0) |
|---|---|---|
| 音声1:低い「イ」 | 0.8 kPa / a_CT = 0.47 | 約 177 Hz |
| 音声2:低い「ア」 | 0.8 kPa / a_CT = 0.53 | 約 177 Hz |
| 音声3:高い「イ」 | 1.5 kPa / a_CT = 0.88 | 約 321 Hz |
| 音声4:高い「ア」 | 1.5 kPa / a_CT = 0.82 | 約 324 Hz |
4つの音声とも a_TA = 0.24・a_LC = 0.5 は共通ですが、母音によって声道からの影響でピッチがずれるため、聞き比べる声の高さを近づける目的で a_CT を微調整しています。そのため、筋肉の設定を完全に固定して母音だけを入れ替えた比較ではない点にご注意ください。
音声波形には唇から出る体積速度の時間微分を使い、立ち上がりの 0.3 秒を除いた区間で4音声の実効値(RMS)が同じになるよう音量をそろえています。ここで聞き比べているのは主に音色や倍音のバランスです。「鼻腔共鳴」の記事とは音量処理が異なるため、この4音声から母音ごとの音量の大小を比べることはできません。
連続体モデルによる補助的な確認
「母音と高音」の記事では、図や比較音声を作った三質量モデルとは別に、声帯断面を細かいメッシュに分けた連続体モデルでも、「イ」や「ウ」の F1 付近に声の高さが引き寄せられる傾向が出るかを補助的に調べています。
ただし、連続体モデルでは物性値や初期の隙間に調整を加えているほか、組み合わせている声道モデルでも条件によって F1 の共鳴ピークが実測の参考値より鋭くなることがあります。そのため、声帯と声道の相互作用が実際の人の発声より強く出ている可能性があり、複数の声帯モデルで同じ傾向が見られたとしても、声道側の共通した近似の影響は残ります。また、肺圧の設定を変えると「ア」でも音程が不連続に跳ぶ場面が見られたため、「『ア』ならどんな条件でもなめらかに高音へ移れる」とまでは言えません。
結果の読み取り方と適用範囲
| 目的・用途 | v1.0 での扱い |
|---|---|
| 発声の仕組みを調べ、仮説を立てる | 設定した声道形状や筋活動の範囲内で、共鳴・反共鳴や倍音スペクトル、声帯へ跳ね返る音圧がどう変化するかを比較するのに適しています。 |
| 記事の図解や比較音声として示す | 計算条件を明示したうえで、モデルの中で起きた物理的な変化を視覚・聴覚で伝えるために使っています。掲載している音声はすべてモデルの計算出力であり、人の歌声を録音したものではありません。 |
| 個人の発声をピンポイントで予測する | 一人ひとりの声道や声帯の形を特定し、「この人は何 Hz で換声点が来るか」「どれだけの肺圧が必要か」を個別に言い当てるような予測精度は確認していません。 |
| 歌っているときの体感や喉の状態を断定する | 鼻や顔の振動感覚、喉への負担感、実際の筋肉の活動量は計算の対象外です。また、録音された声の特徴だけから「喉の中がこう動いている」と一対一で特定することもできません。 |
| 練習法やコースの効果を証明する | 物理的な仕組みから「こういう練習が有効ではないか」という仮説を立てる手がかりにはなりますが、実際に人が練習して上達するかどうかは、比較条件を設けた別の検証が必要です。 |
加えて、メインで使っている三質量モデルは構造を単純化しているため、声帯内部の細かな変形や、実際の人間のような明確な「地声と裏声の切り替わり」までは表現しきれません。また、実際の歌い手は自分の声を耳で聞きながら口の形や筋肉の使い方を無意識に調整しますが、v1.0 の記事の計算にはそうしたフィードバック制御は組み込んでいません。シミュレーション結果は、あくまで「指定した形と条件を固定したときに起こる物理現象」として読み取る必要があります。
今後の検証とバージョンの扱い
次のステップは、モデルの調整に使っていない独立した実測データと突き合わせて、実際の人の声をどこまで予測できるかを確かめることです。録音した音声に加え、必要に応じて声帯の接触を調べる EGG(電気声門図)などの計測データとも比較し、発声条件や個人ごとにどれくらい誤差が出るのかを明らかにしていきます。
今後、ユーザーのみなさんの音声データを研究に用いる場合は、研究目的と利用範囲にご同意いただいたうえで、録音条件や発声課題、練習メニューをそろえて検証を行います。データを探索して得た仮説と、別の参加者であらためて確かめた検証結果とを明確に分け、仮説が支持されなかった場合も記事の説明やコース設計の見直しにきちんと反映していく方針です。
このページは、公開記事から v1.0 時点の計算条件を参照できるよう残しておきます。今後モデルや設定を変更して図や音声の結果が変わる場合は、新しいバージョンとして変更点を公開し、各記事には実際に使用したバージョンを明記します。表現の修正や誤記の訂正を行った際は、下の更新履歴に記録します。
| 日付 | バージョン・変更内容 |
|---|---|
| 2026年10月24日 | v1.0 公開:「鼻腔共鳴」「母音と高音」の2記事で使用したモデル構成・計算条件・検証結果・適用範囲をまとめ、声帯(三質量・四質量・連続体)・声道・鼻腔の構成図を掲載。 |
このモデルを使用した記事
鼻腔共鳴って本当にあるの?「鼻に響かせる」の正体を物理シミュレーションで検証軟口蓋の開閉と喉頭蓋管の広さを変えたときに、声の音量や倍音がどう変化するかをシミュレーション音声とグラフで検証した記事です。「イ」「ウ」で高い音が苦しいのはなぜ?母音と高音の出しやすさの関係母音ごとの第1フォルマント(F1)の違いと、声道から声帯へ跳ね返る音圧が高音の出しやすさにどう関わるかを解説した記事です。関連する声帯モデルの計算
音程が不安定なのは地声のせい? TA・CTの働きから考える声区と音程のコントロール三質量声帯モデル単体を使い、TA・CTの入力と音高の関係を調べた記事です。声道との結合を含めないなど、v1.0の2記事とは計算条件が異なります。研究知見・今回の計算・声区切替に関する仮説を区別しています。主な参考文献
モデルの設計や入力データ、計算結果の照合にあたって参照した主な論文です。各文献から特定の数式や計測データを取り入れており、論文内のすべての実験結果を再現しているわけではありません。
- Story BH, Titze IR (1995). Voice simulation with a body-cover model of the vocal folds. *J Acoust Soc Am*, 97(2), 1249–1260. 三質量声帯モデルの基礎として使用。
- Titze IR, Story BH (2002). Rules for controlling low-dimensional vocal fold models with muscle activation. *J Acoust Soc Am*, 112(3), 1064–1076. 筋活動パラメータから質量・ばね定数を求める変換則に使用(実装では LeTalker や後続論文の記述も参照)。
- Lowell SY, Story BH (2006). Simulated effects of cricothyroid and thyroarytenoid muscle activation on adult-male vocal fold vibration. *J Acoust Soc Am*, 120(1), 386–397. Table I の質量・ばね定数との数値照合に使用。
- Tokuda IT, Herzel H (2009). Biomechanical simulation of chest-falsetto transitions and the influence of vocal tract resonators. *Proc. APSIPA ASC 2009*, 520–524. 拡張実装である四質量 body-cover モデルの参考(v1.0 の2記事の主計算には未使用)。
- Story BH (2008). Comparison of magnetic resonance imaging-based vocal tract area functions obtained from the same speaker in 1994 and 2002. *J Acoust Soc Am*, 123(1), 327–335. 声道断面積データの入力値、および計算フォルマントの照合に使用。
- Dang J, Honda K, Suzuki H (1994). Morphological and acoustical analysis of the nasal and the paranasal cavities. *J Acoust Soc Am*, 96(4), 2088–2100. 鼻腔・副鼻腔の形状および音響損失の設定で参考。
- Dang J, Honda K (1996). An improved vocal tract model of vowel production implementing piriform resonance and transvelar nasal coupling. *Proc. ICSLP 1996*, 965–968. 軟口蓋閉鎖時の経軟口蓋結合モデルの参考。
- Dang J, Honda K (1996). Acoustic characteristics of the human paranasal sinuses derived from transmission characteristic measurement and morphological observation. *J Acoust Soc Am*, 100(5), 3374–3383. bilateral 鼻腔の副鼻腔の共鳴器(上顎洞・前頭洞・蝶形洞)の周波数の照合で参考。
- Pruthi T, Espy-Wilson CY, Story BH (2007). Simulation and analysis of nasalized vowels based on magnetic resonance imaging data. *J Acoust Soc Am*, 121(6), 3858–3873. 左右の鼻道の非対称と副鼻腔による反共鳴の照合で参考。
- Yazawa K, Kondo M (2019). Acoustic characteristics of Japanese short and long vowels: Formant displacement effect revisited. *Proc. ICPhS 2019*, 671–675. 日本語の母音「ウ」の目標フォルマント値として使用。
- Titze IR (2008). Nonlinear source–filter coupling in phonation: Theory. *J Acoust Soc Am*, 123(5), 2733–2749. 声帯と声道の相互作用に関する理論的背景。